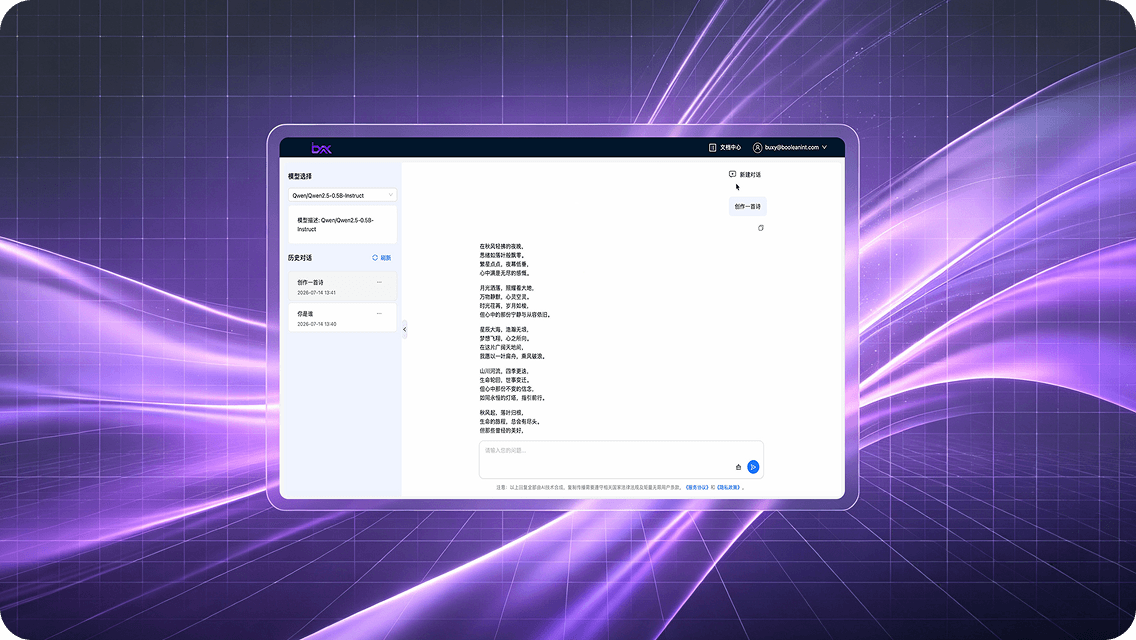
BooleanMax(博伦·极)是企业级大模型推理服务平台,平台具备众多优质大模型(涵盖对话、生图、生视频、代码、多模态等),提供标准化API与交互式对话界面。开发者无需关注底层算力与繁杂的模型部署,只需几行代码即可将AI能力无缝集成至业务系统,加速大模型应用落地。

核心优势
为企业数字化转型提供全方位的模型推理基础设施保障。

模型丰富
支持各类优质大模型,千问、DeepSeek、智谱等各类大模型。

极致推理性能
底层深度联动算力调度平台,享受持续算力保障。

标准化API
提供统一API接入,兼容OpenAI接口格式,支持平滑迁移。

零门槛接入
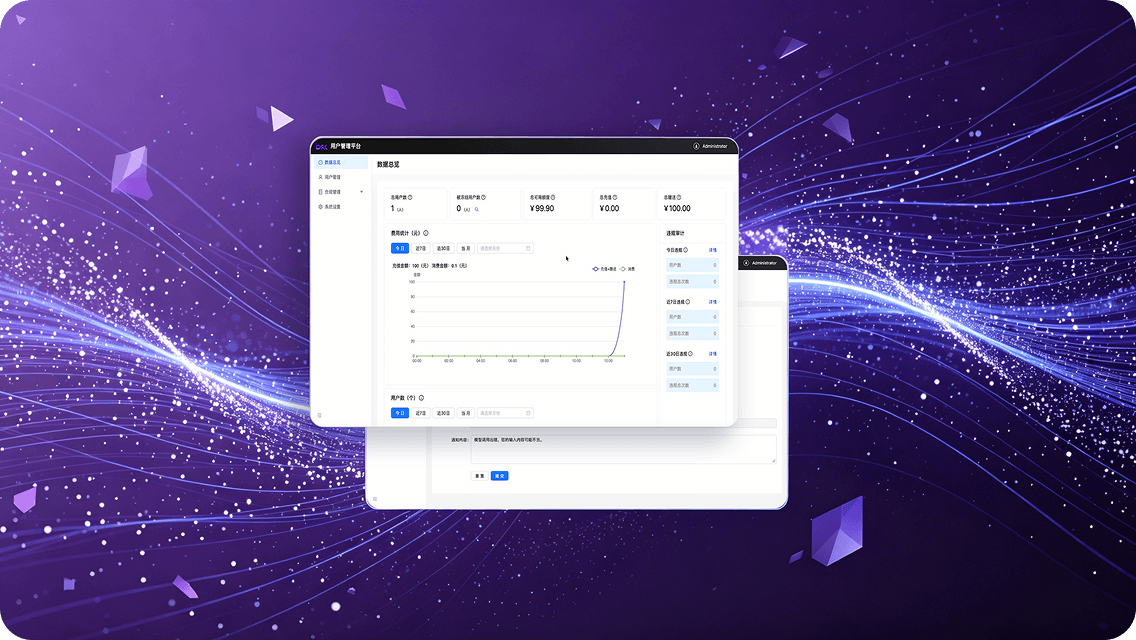
注册即可调用,告别复杂的环境配置。

服务稳定性
提供高可用、高并发的大模型推理服务。

智能路由与负载
根据请求类型与模型负载,智能分发至最优推理实例。

企业级安全
支持敏感词校验,确保内容合规安全。

按量计费
精细化计量计费,实时预测每一笔调用成本。
模型服务
博伦智汇上线大模型 API 调用和线上体验服务,现已支持多种大语言模型、多模态理解模型、图像生成模型等主流模型。新用户登录即送 100 元体验金,欢迎来体验,即刻开始大模型旅程。
deepseek-ai/DeepSeek-V4-Flash-0731
DeepSeek-V4-Flash是DeepSeek-V4系列中的预览版MoE语言模型,总参数量为284B,激活参数量为13B,适用于日常问答、复杂分析、长文本理解与代码等多类任务。
ZhipuAI/GLM-5.2
GLM-5.2在长程任务能力上实现了显著飞跃,支持百万token上下文,改进的架构在每四个稀疏注意力层中复用同一个索引器,具备更强的编程能力。
Tencent-Hunyuan/Hy3
Hy3是腾讯混元推出的新一代大模型,采用MoE架构,模型在高质量内容创作、数理逻辑推理、代码生成、多轮对话等核心能力上表现卓越。
Qwen/Qwen3.8-27B
Qwen3.8-27B模型现在能更流畅、精准地处理前端工作流和仓库级推理任务,可保留历史消息中的推理上下文,从而简化迭代开发并降低开销。
Qwen/Qwen3.5-0.8B
Qwen3.5-0.8B融合了多模态学习、架构效率、强化学习规模扩展等方面的突破,为开发者和企业带来能力与效率提升。
deepseek-ai/DeepSeek-V4-Pro
DeepSeek-V4-Pro的Agent能力显著增强,丰富的世界知识,采用混合注意力机制,结合压缩稀疏注意力(CSA)与重度压缩注意力(HCA),显著提升长上下文处理效率。
Tongyi-MAI/Z-Image
Z-Image 是 Z-Image(造相)系列的图像生成基础模型,专为高质量、强生成多样性、广泛的风格覆盖能力以及精准的提示词遵循而设计。
black-forest-labs/FLUX.1-schnell
FLUX.1-schnell模型具有120亿参数,能够根据文本描述生成图像,使用潜在对抗扩散蒸馏技术进行训练,可以在1到4步内生成高质量的图像。
Wan-AI/Wan2.2-TI2V-5B-Diffusers
Wan2.2-TI2V-5B-Diffusers模型使用高级Wan2.2-VAE构建,实现了16×16×4的压缩比,该模型支持文本到视频和图像到视频生成。

MiniMax/MiniMax-H3-Base-FL2VA
MiniMax H3 是一个通用型、全模态生成系统。它支持对由文本、图像、视频和音频组成的多模态上下文进行统一理解,并可生成最高达 2K 分辨率、最长 15 秒、包含原生立体声音频的视频。
BestWishYSH/Helios-Distilled
Helios 是一种突破性的视频生成模型,可在单张 H100 GPU 上以 19.5 FPS 的速度(在单张 Ascend NPU 上约为 10 FPS)生成分钟级高质量视频——且无需依赖传统的长视频防漂移策略或标准视频加速技术。
deepseek-ai/DeepSeek-V4-Flash-0731
DeepSeek-V4-Flash是DeepSeek-V4系列中的预览版MoE语言模型,总参数量为284B,激活参数量为13B,适用于日常问答、复杂分析、长文本理解与代码等多类任务。
ZhipuAI/GLM-5.2
GLM-5.2在长程任务能力上实现了显著飞跃,支持百万token上下文,改进的架构在每四个稀疏注意力层中复用同一个索引器,具备更强的编程能力。
Tencent-Hunyuan/Hy3
Hy3是腾讯混元推出的新一代大模型,采用MoE架构,模型在高质量内容创作、数理逻辑推理、代码生成、多轮对话等核心能力上表现卓越。
Qwen/Qwen3.8-27B
Qwen3.8-27B模型现在能更流畅、精准地处理前端工作流和仓库级推理任务,可保留历史消息中的推理上下文,从而简化迭代开发并降低开销。
Qwen/Qwen3.5-0.8B
Qwen3.5-0.8B融合了多模态学习、架构效率、强化学习规模扩展等方面的突破,为开发者和企业带来能力与效率提升。
deepseek-ai/DeepSeek-V4-Pro
DeepSeek-V4-Pro的Agent能力显著增强,丰富的世界知识,采用混合注意力机制,结合压缩稀疏注意力(CSA)与重度压缩注意力(HCA),显著提升长上下文处理效率。
Tongyi-MAI/Z-Image
Z-Image 是 Z-Image(造相)系列的图像生成基础模型,专为高质量、强生成多样性、广泛的风格覆盖能力以及精准的提示词遵循而设计。
black-forest-labs/FLUX.1-schnell
FLUX.1-schnell模型具有120亿参数,能够根据文本描述生成图像,使用潜在对抗扩散蒸馏技术进行训练,可以在1到4步内生成高质量的图像。
Wan-AI/Wan2.2-TI2V-5B-Diffusers
Wan2.2-TI2V-5B-Diffusers模型使用高级Wan2.2-VAE构建,实现了16×16×4的压缩比,该模型支持文本到视频和图像到视频生成。
MiniMax/MiniMax-H3-Base-FL2VA
MiniMax H3 是一个通用型、全模态生成系统。它支持对由文本、图像、视频和音频组成的多模态上下文进行统一理解,并可生成最高达 2K 分辨率、最长 15 秒、包含原生立体声音频的视频。
BestWishYSH/Helios-Distilled
Helios 是一种突破性的视频生成模型,可在单张 H100 GPU 上以 19.5 FPS 的速度(在单张 Ascend NPU 上约为 10 FPS)生成分钟级高质量视频——且无需依赖传统的长视频防漂移策略或标准视频加速技术。
deepseek-ai/DeepSeek-V4-Flash-0731
DeepSeek-V4-Flash是DeepSeek-V4系列中的预览版MoE语言模型,总参数量为284B,激活参数量为13B,适用于日常问答、复杂分析、长文本理解与代码等多类任务。
ZhipuAI/GLM-5.2
GLM-5.2在长程任务能力上实现了显著飞跃,支持百万token上下文,改进的架构在每四个稀疏注意力层中复用同一个索引器,具备更强的编程能力。
Tencent-Hunyuan/Hy3
Hy3是腾讯混元推出的新一代大模型,采用MoE架构,模型在高质量内容创作、数理逻辑推理、代码生成、多轮对话等核心能力上表现卓越。
Qwen/Qwen3.8-27B
Qwen3.8-27B模型现在能更流畅、精准地处理前端工作流和仓库级推理任务,可保留历史消息中的推理上下文,从而简化迭代开发并降低开销。
Qwen/Qwen3.5-0.8B
Qwen3.5-0.8B融合了多模态学习、架构效率、强化学习规模扩展等方面的突破,为开发者和企业带来能力与效率提升。
deepseek-ai/DeepSeek-V4-Pro
DeepSeek-V4-Pro的Agent能力显著增强,丰富的世界知识,采用混合注意力机制,结合压缩稀疏注意力(CSA)与重度压缩注意力(HCA),显著提升长上下文处理效率。
Tongyi-MAI/Z-Image
Z-Image 是 Z-Image(造相)系列的图像生成基础模型,专为高质量、强生成多样性、广泛的风格覆盖能力以及精准的提示词遵循而设计。
black-forest-labs/FLUX.1-schnell
FLUX.1-schnell模型具有120亿参数,能够根据文本描述生成图像,使用潜在对抗扩散蒸馏技术进行训练,可以在1到4步内生成高质量的图像。
Wan-AI/Wan2.2-TI2V-5B-Diffusers
Wan2.2-TI2V-5B-Diffusers模型使用高级Wan2.2-VAE构建,实现了16×16×4的压缩比,该模型支持文本到视频和图像到视频生成。
MiniMax/MiniMax-H3-Base-FL2VA
MiniMax H3 是一个通用型、全模态生成系统。它支持对由文本、图像、视频和音频组成的多模态上下文进行统一理解,并可生成最高达 2K 分辨率、最长 15 秒、包含原生立体声音频的视频。
BestWishYSH/Helios-Distilled
Helios 是一种突破性的视频生成模型,可在单张 H100 GPU 上以 19.5 FPS 的速度(在单张 Ascend NPU 上约为 10 FPS)生成分钟级高质量视频——且无需依赖传统的长视频防漂移策略或标准视频加速技术。
为什么能省更多
便宜来自技术,不是补贴

异构算力调度
自研调度平台统一管理国产+进口GPU,按任务自动匹配最优算力,资源利用率从30%提到80%

闲置算力池化
接入边缘闲置算力资源,把“闲着的卡”变成“在赚钱的卡”,供给侧成本天然更低

推理引擎优化
KVCache复用、PD分离、连续批处理,同等硬件下吞吐提升数倍,单Token成本直降