

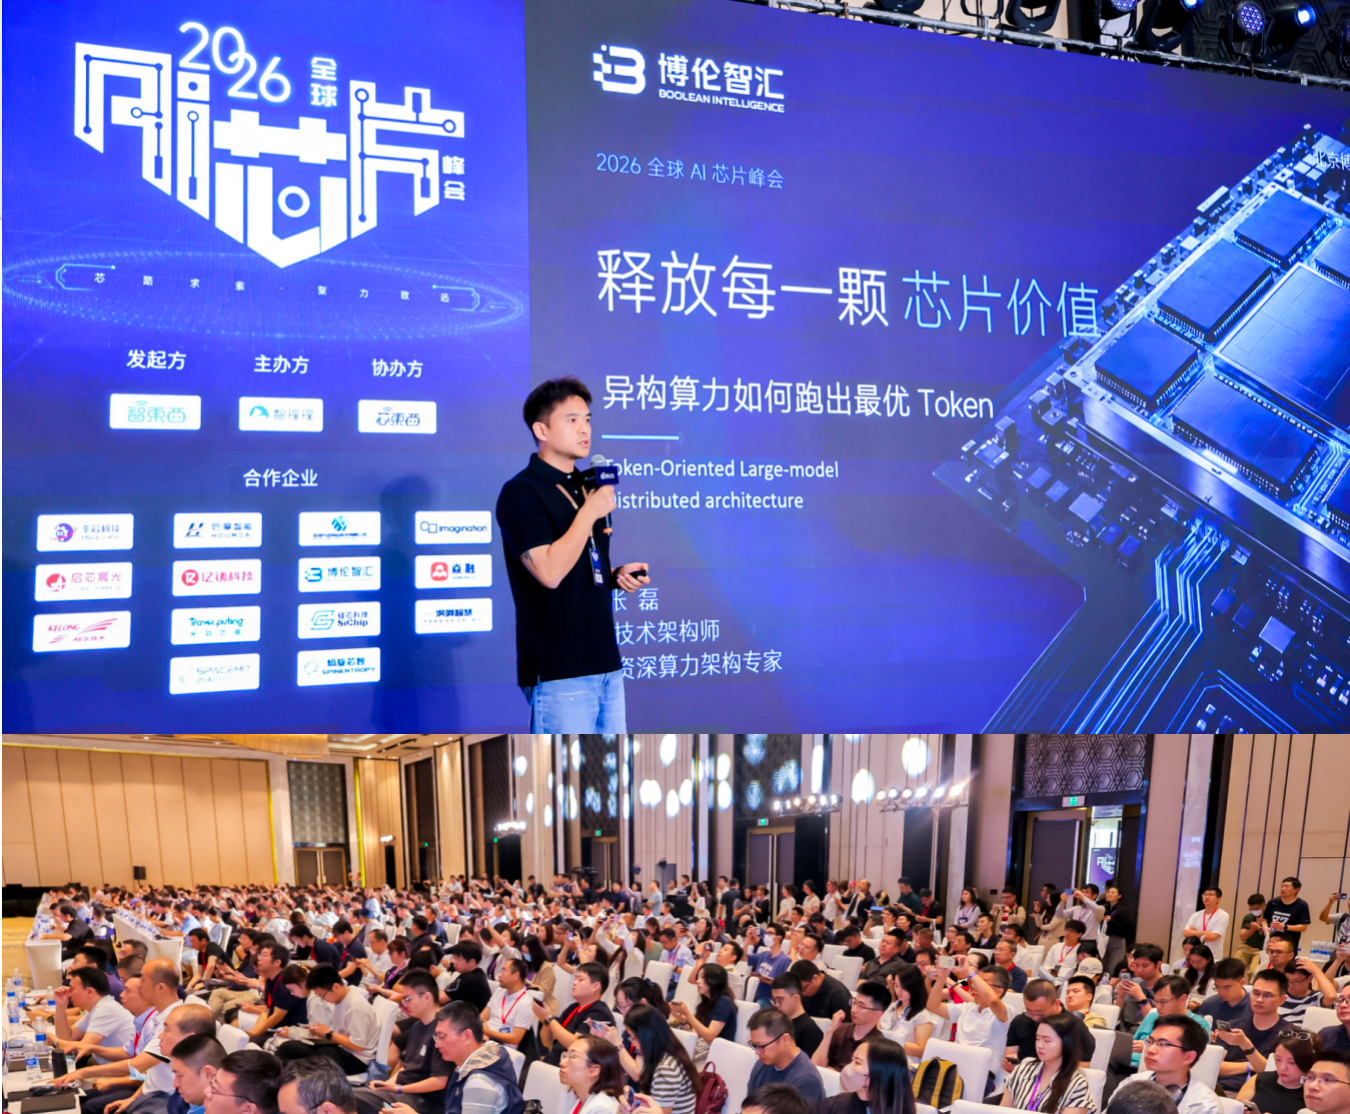
9 月 21 日, 2026 全球 AI 芯片峰会在上海举行。峰会汇聚了国内外主流 AI 芯片厂商、智算中心与 AI 基础设施企业,围绕 Agent 时代的推理芯片、算力集群与推理服务展开讨论。博伦智汇技术架构师张磊受邀在 Agent 推理芯片高峰论坛发表题为《释放每一颗芯片价值:TOLD 架构让异构算力跑出最优 Token》的演讲,系统阐述了异构算力时代的核心命题,并首次完整公开了博伦智汇自研 TOLD 架构与技术路线。
博伦智汇拥有大模型训练经验、国产异构GPU万卡级推理实践和企业级Token输出解决方案能力。我们通过统一纳管国产异构GPU、稳定调度万卡集群,致力于输出更好、更快、更便宜的Token,目标就是把Token价格打下来。
现实与矛盾:需求涨8倍,闲置率60%
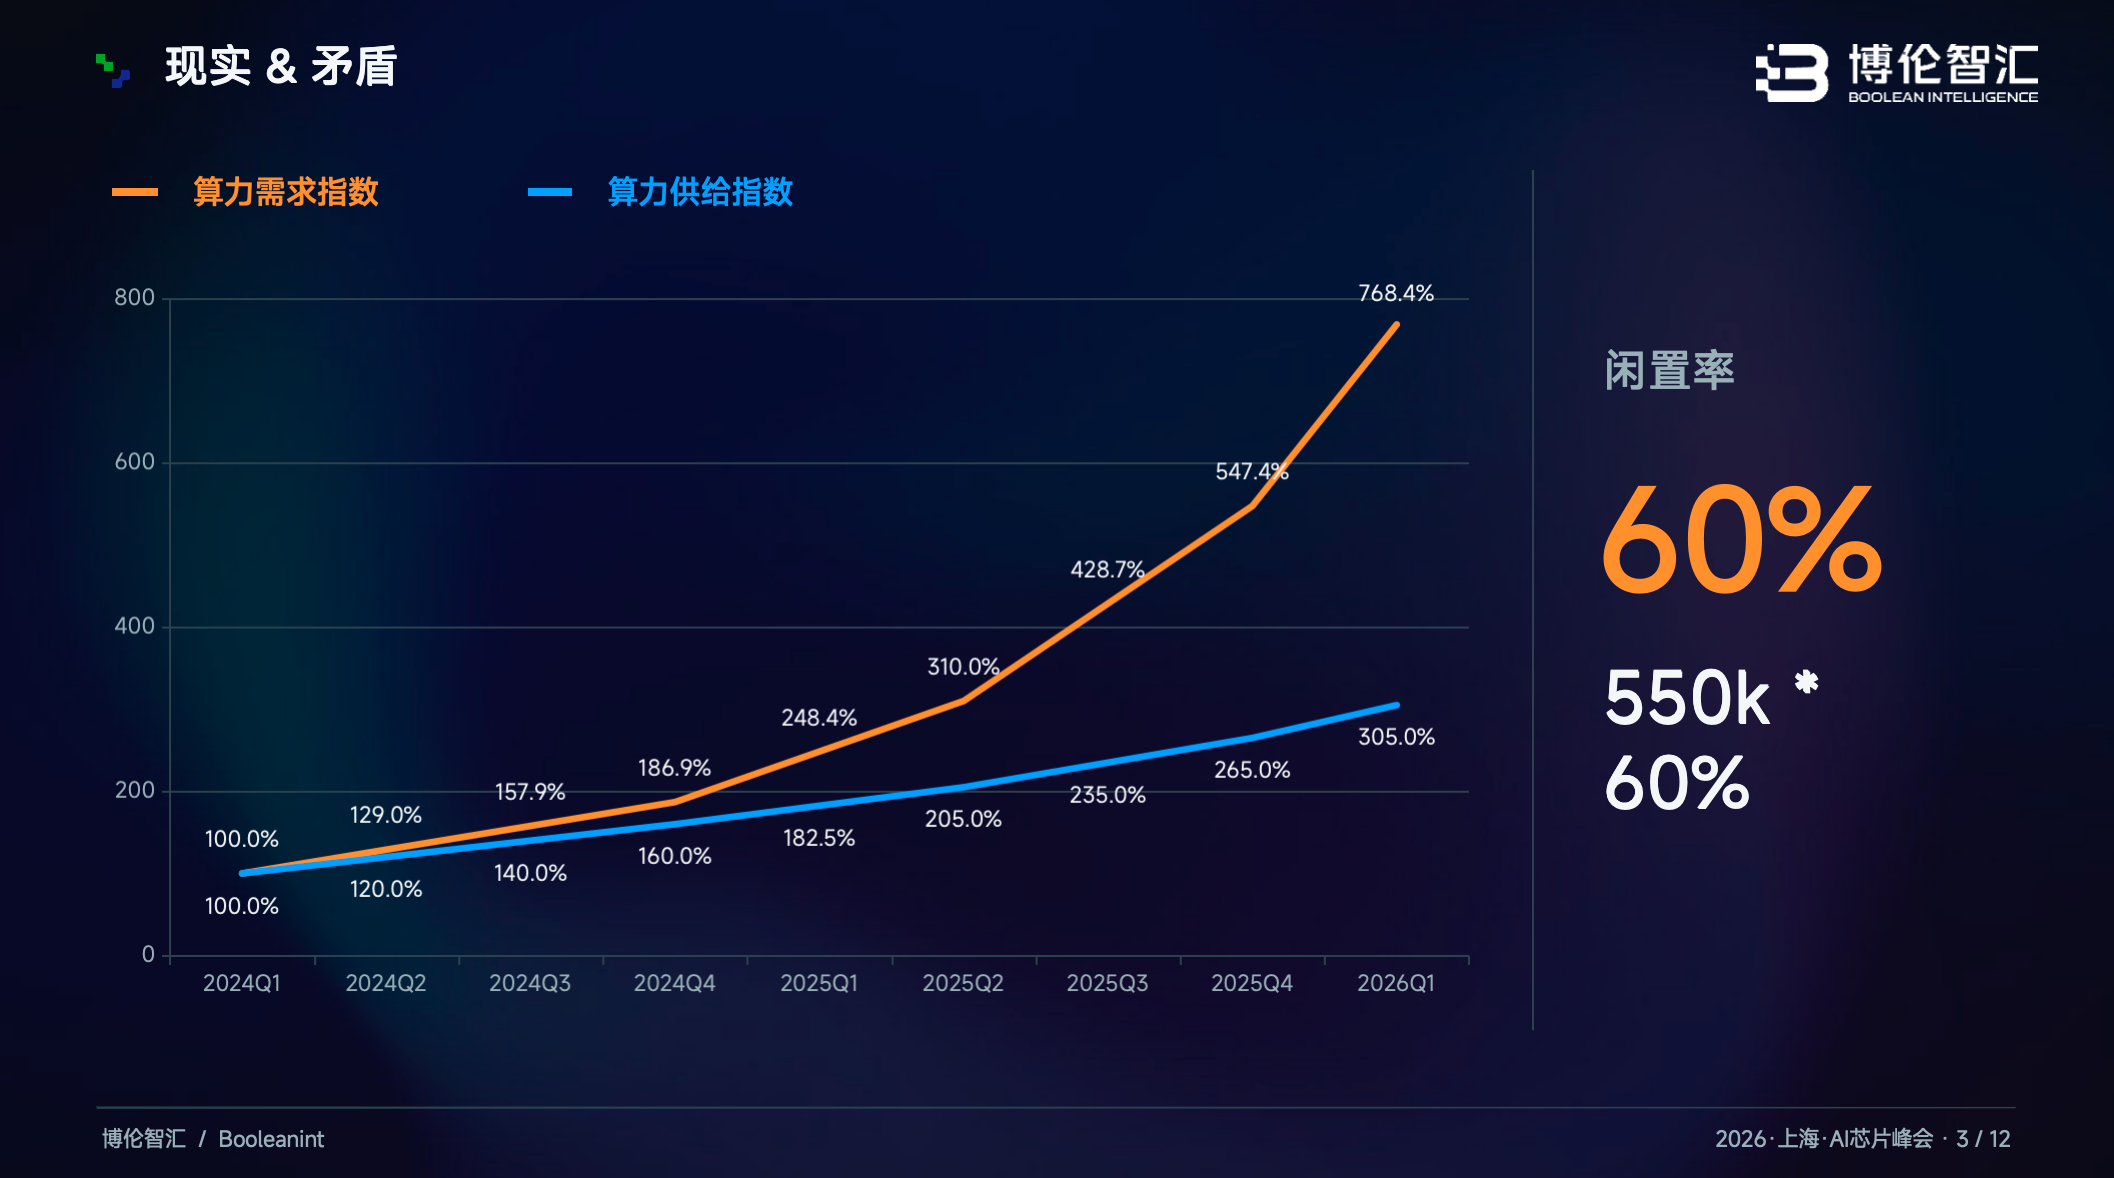
以2024年Q1为基准,两年内国内算力需求增长近8倍,但供给增长远不及预期,算力缺口巨大。另一组数字更值得关注:国内四十多个算力中心,国产芯片平均闲置率60%。一边是巨大算力缺口,一边是大量芯片闲置。我们已解决"造芯片"的问题,为什么还有这么大的缺口?
结构性错配:软件生态的"最后一公里"
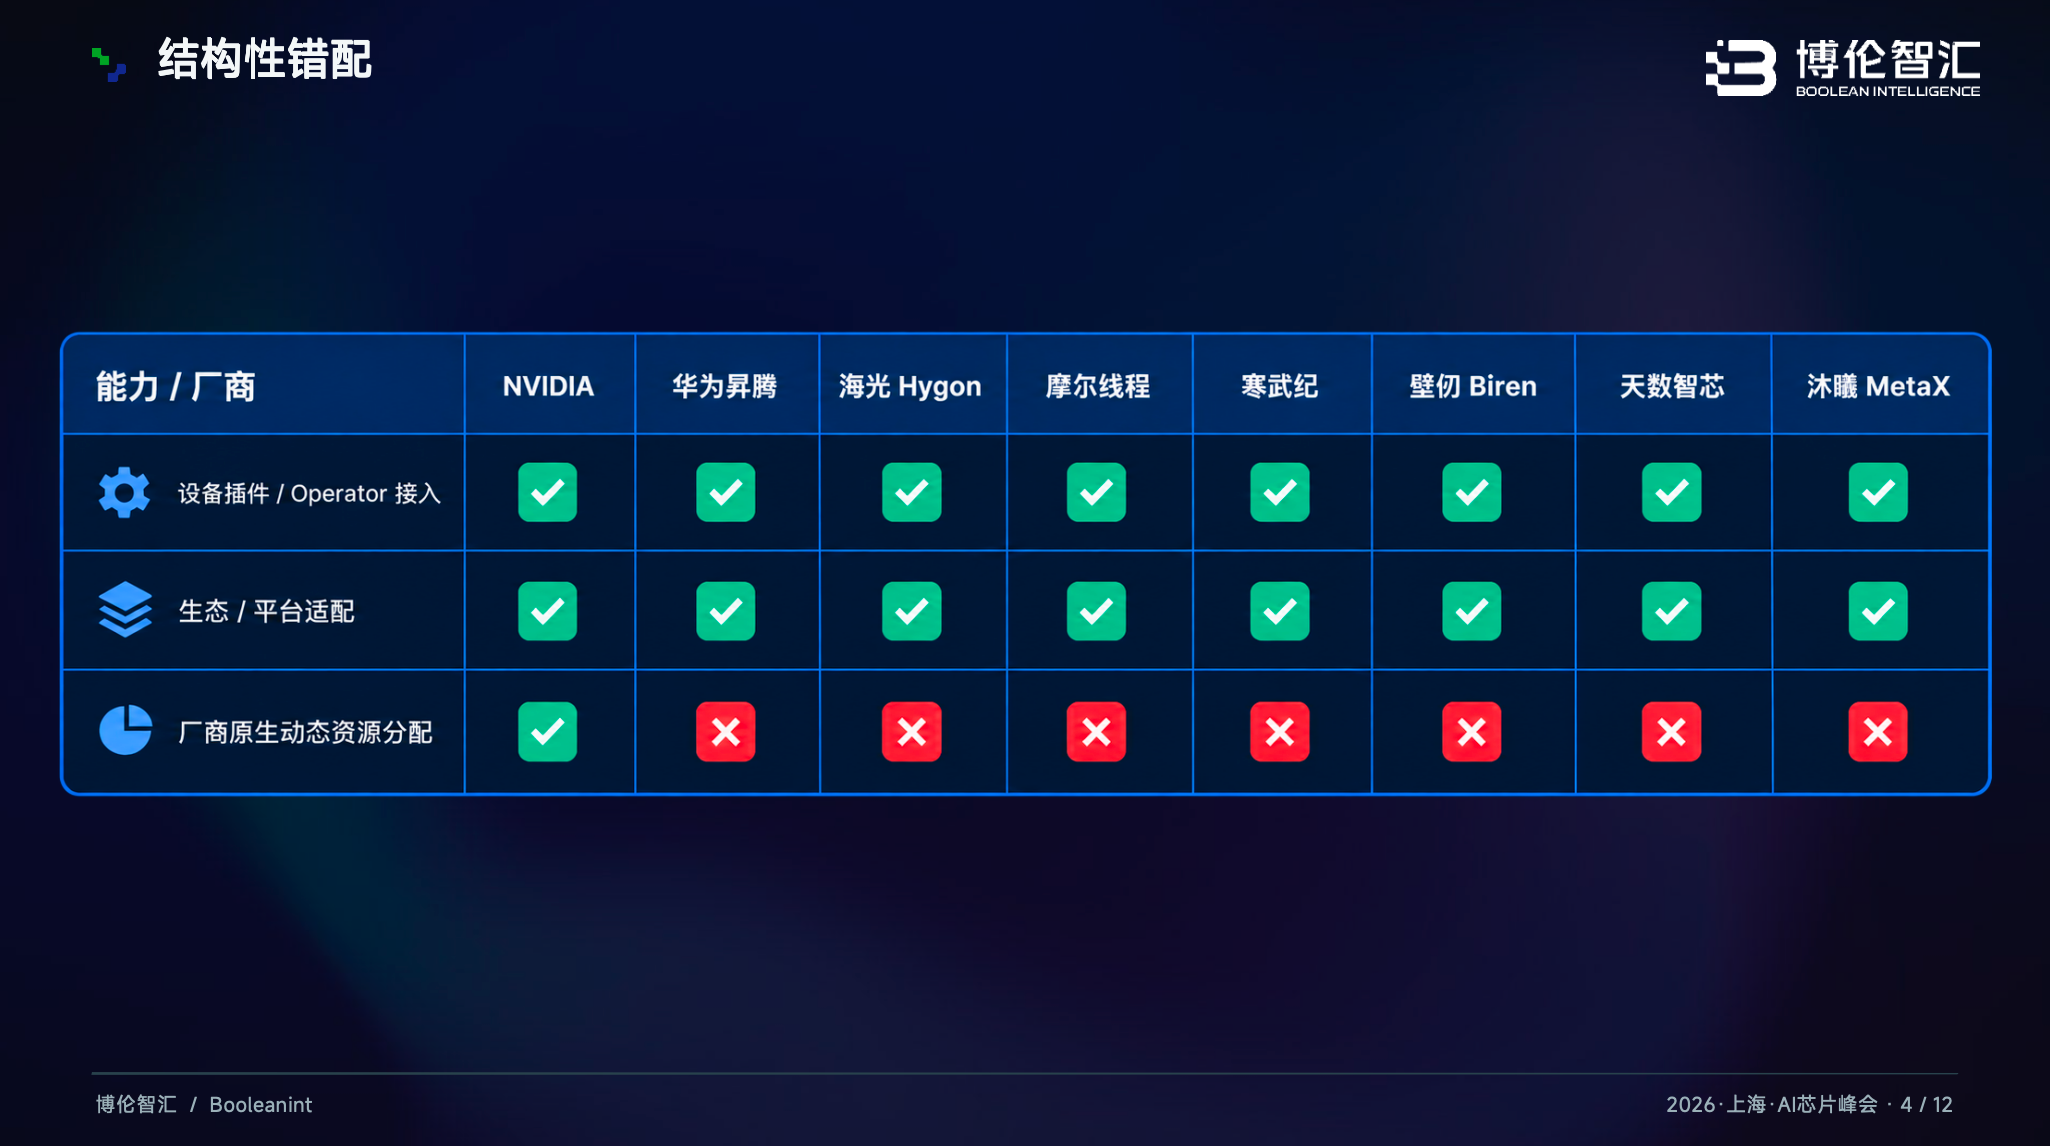
从这个表格可以清晰地看到,虽然国产芯片厂家对设备插件的支持已经非常不错,但对于动态资源分配这部分软件生态,大部分还依赖社区来补齐。比方说国产芯片四小龙里的壁仞和天数,旗下都有非常能打的系列,算力也非常强,但就是因为软件生态这部分缺失,距离在集群上被大量调度起来,还有最后一公里的问题需要解决。
DRA Proxy 设备插件与DRA之间的"翻译官"
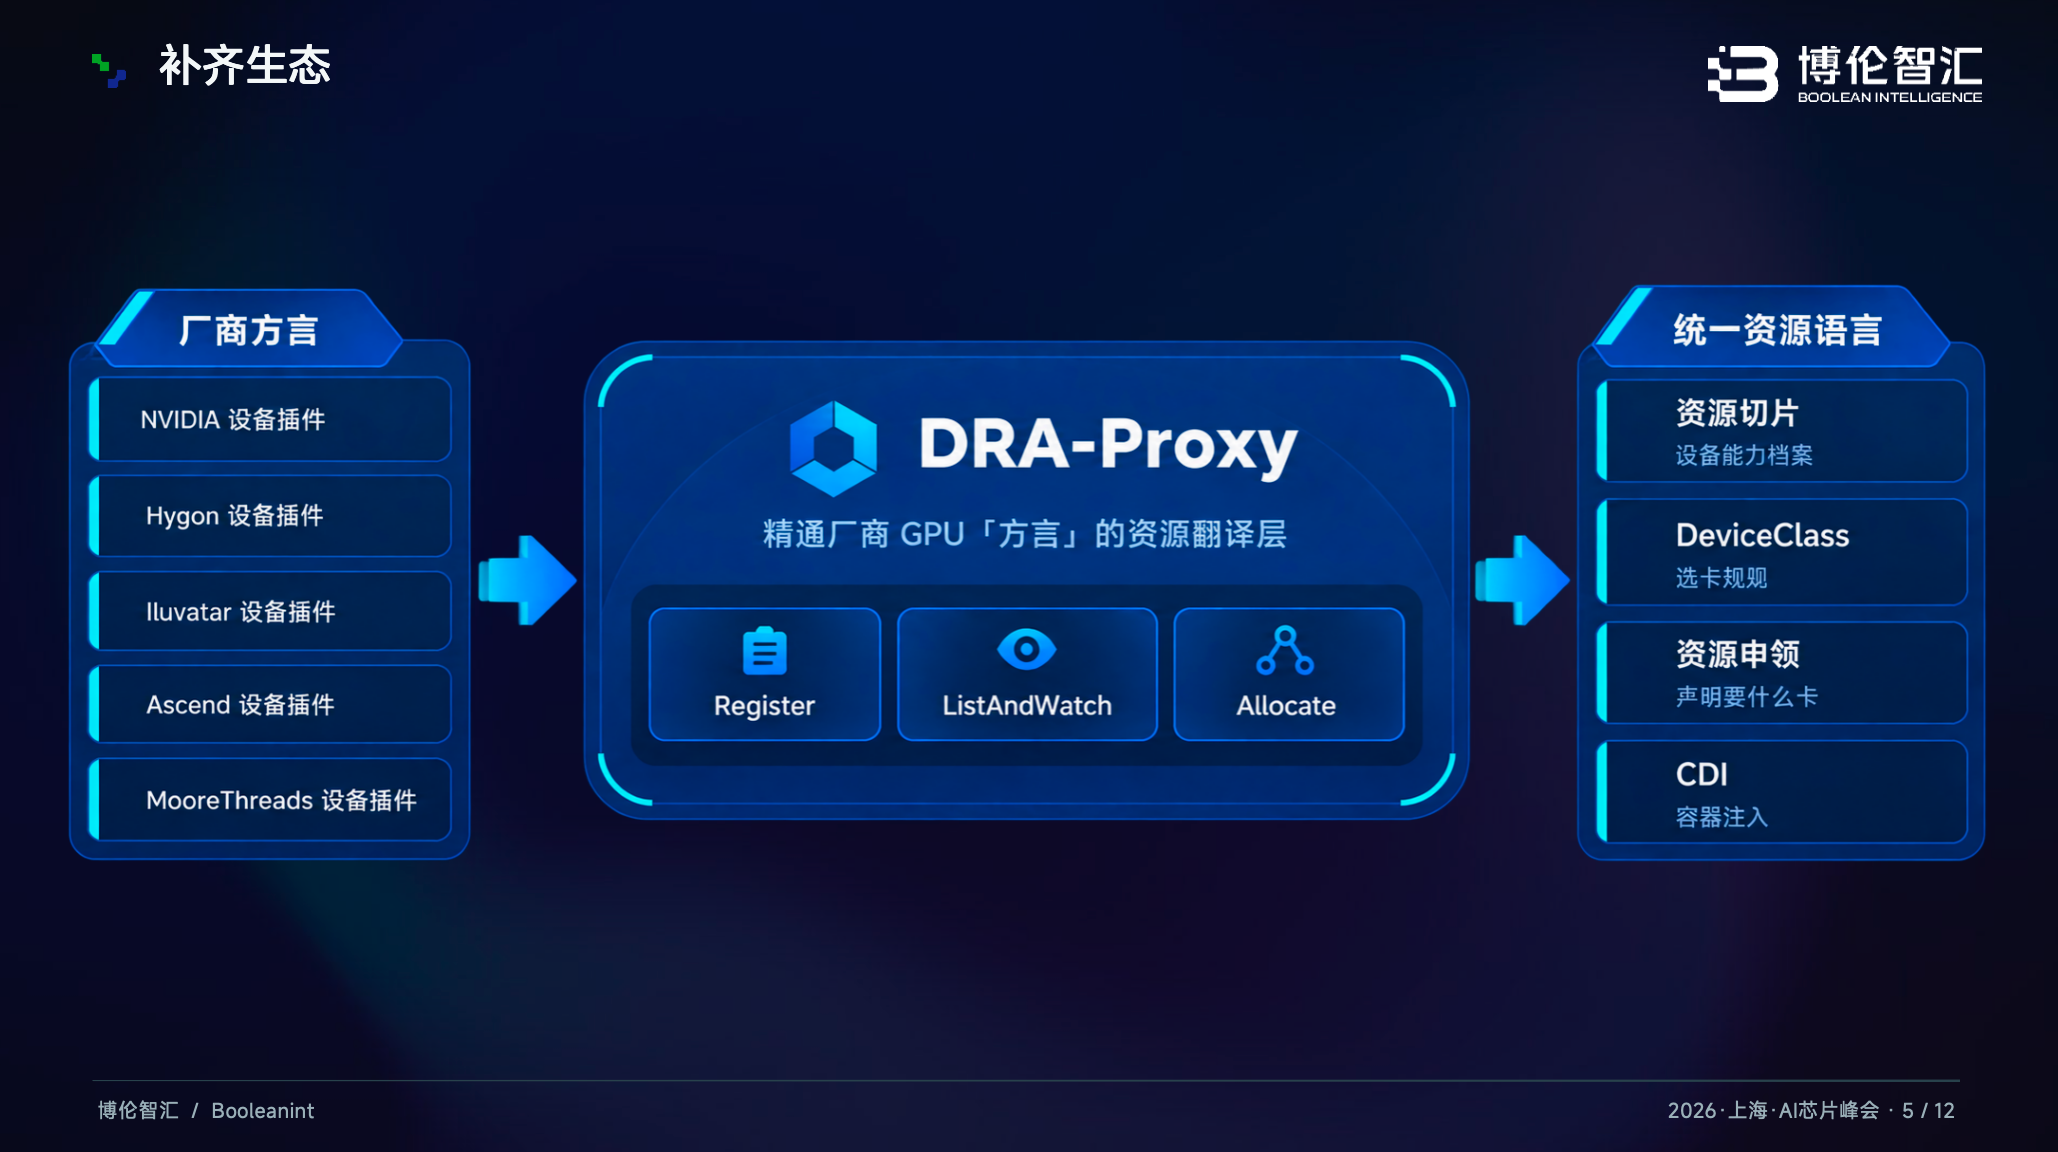
常规思路是自己实现DRA接口做芯片适配,但成本太高。我们换个角度:在K8s和设备插件之间加一层"翻译官",把设备插件的语言翻译成DRA术语,补全信息后以资源切片形式上报K8s——让设备插件管理的GPU重新以DRA方式被平台看见。这就是DRA Proxy。。
工作链路一:资源上报
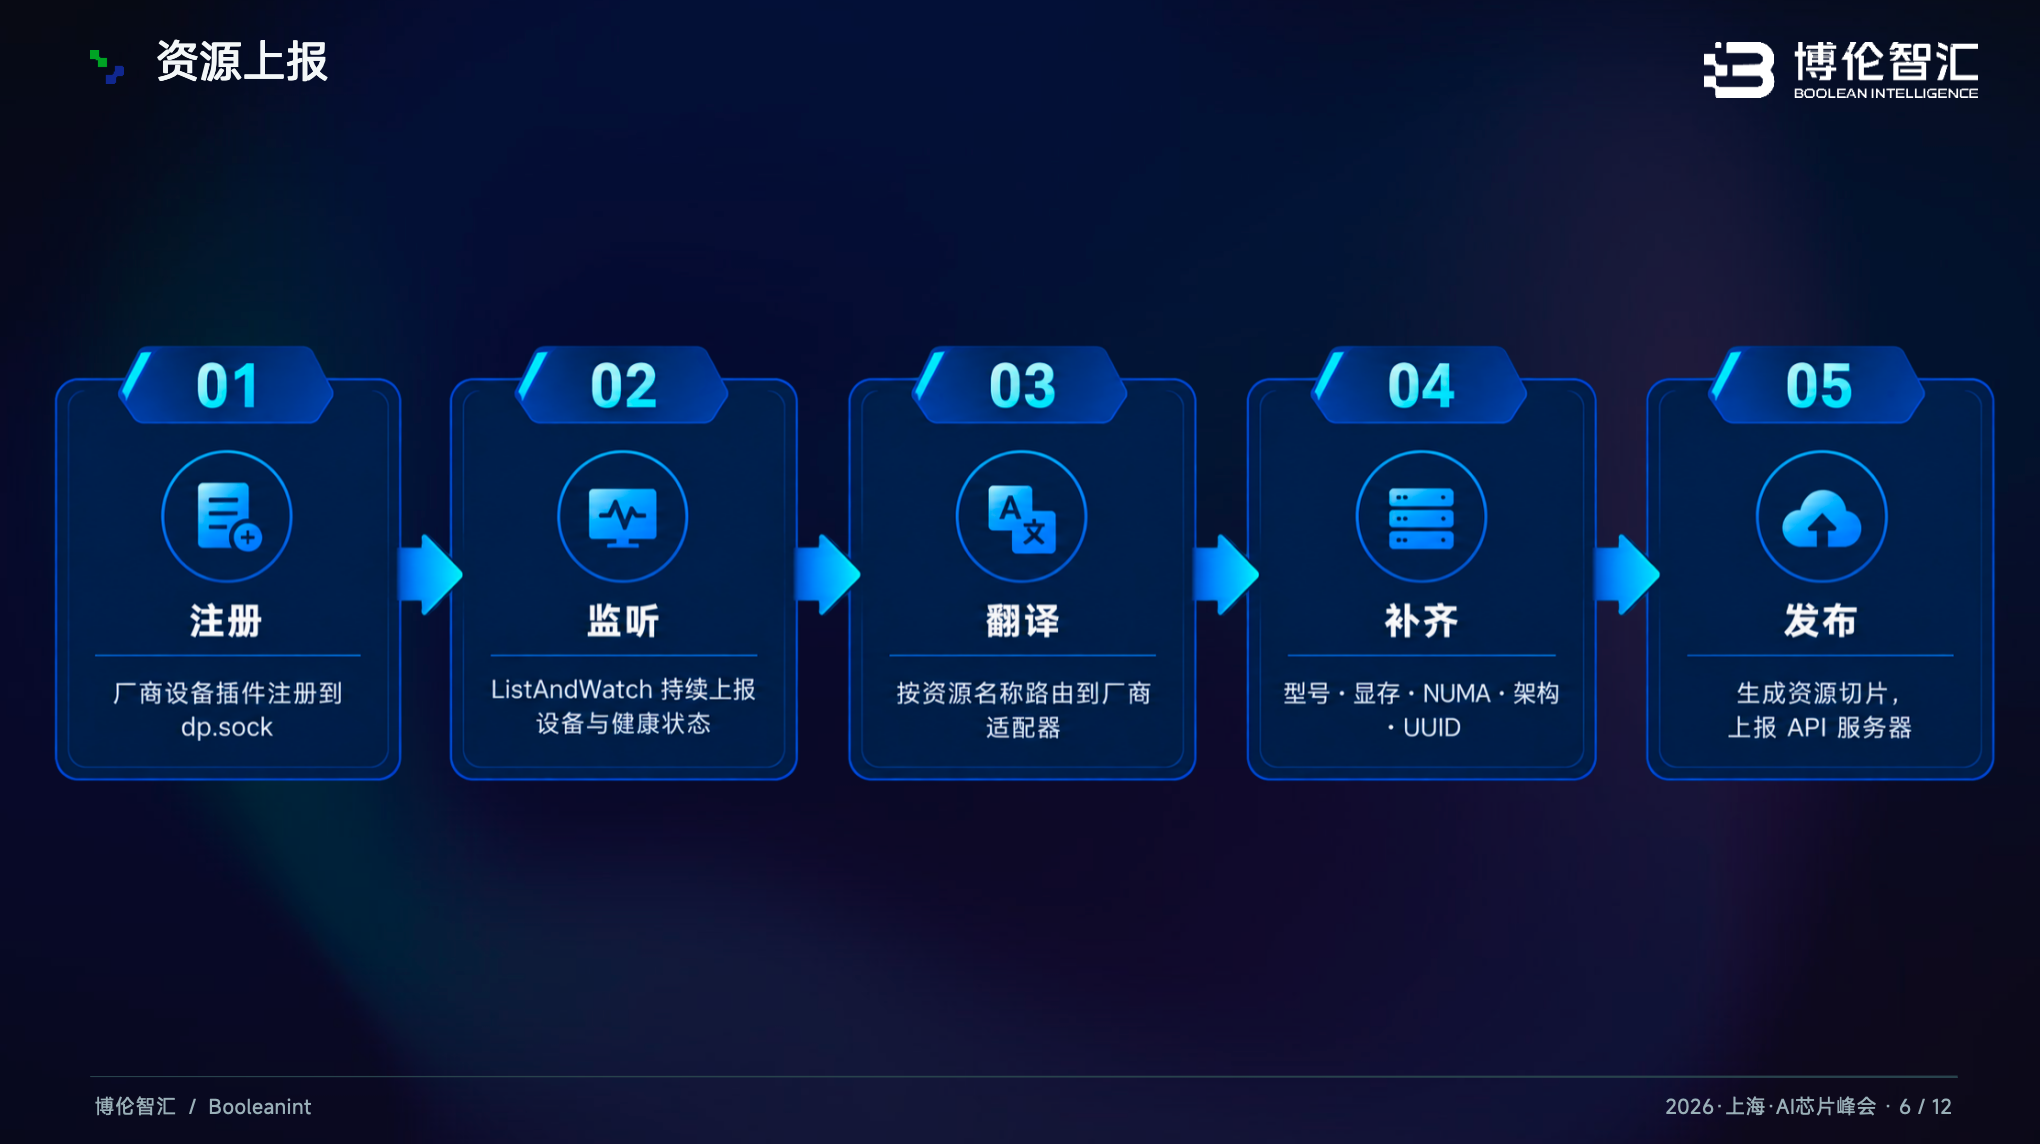
用仓库管理员比喻:采购送来入库单 → 核对材料齐全 → 逐个拆分确认属性 → 翻译成内部术语 → 补全信息 → 录入材料平台。
技术上:设备插件完成注册 → DRA Proxy监听接口获取完整设备信息 → 补全信息 → 以资源切片形式上报K8s → GPU在平台可被发现。。
工作链路二:资源交付
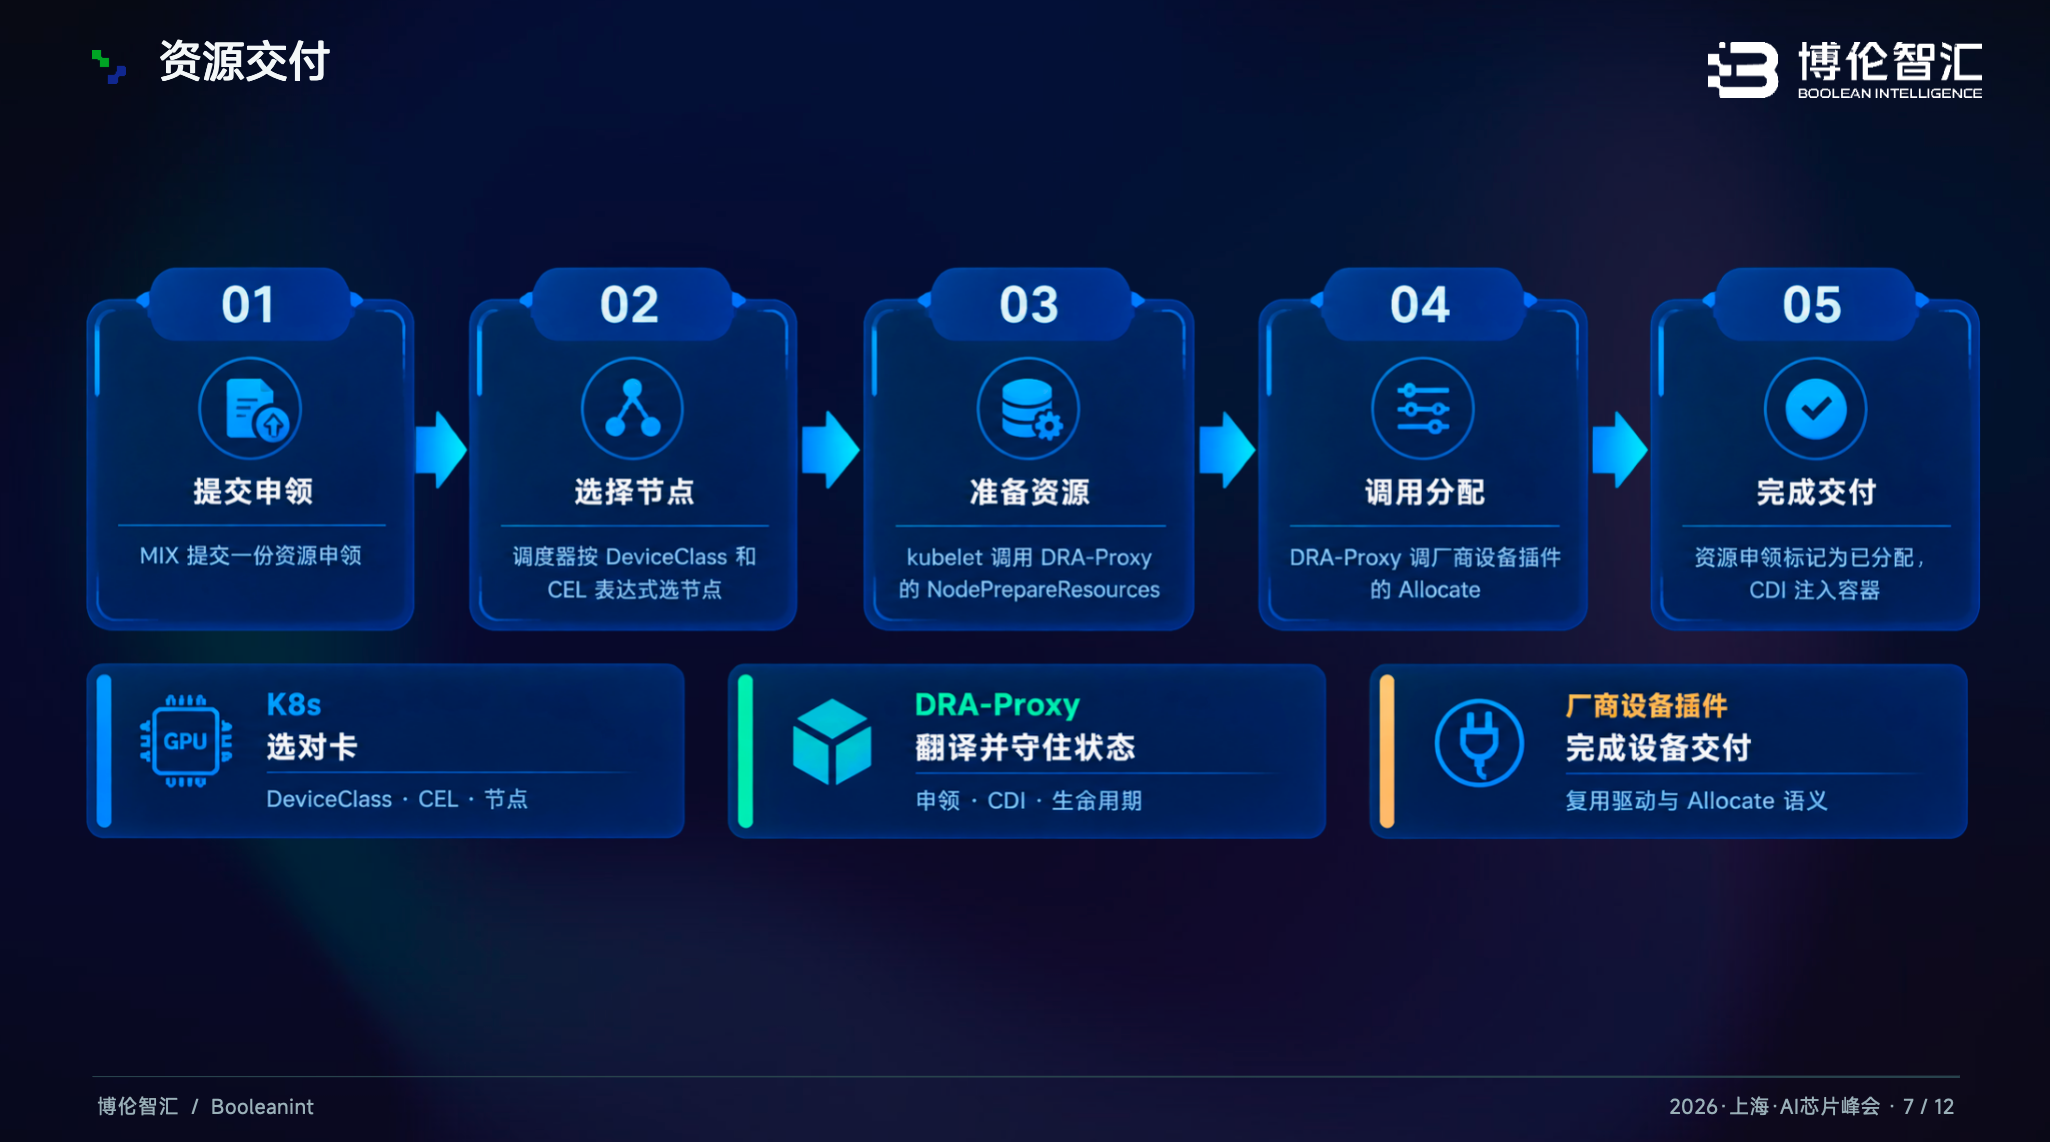
回到仓库管理员:项目经理提领料清单 → 找对应库房 → 打包出库 → 交给执行人员。
技术上:平台出现资源申领单 → 调度器按资源切片和设备类型选最优节点 → 下发调度需求到节点 → 节点调用DRA Proxy资源准备接口 → 设备插件完成设备调度。
K8s、DRA Proxy、设备插件三方协作,完成资源从发现到调度。
DRA Proxy架构剖析
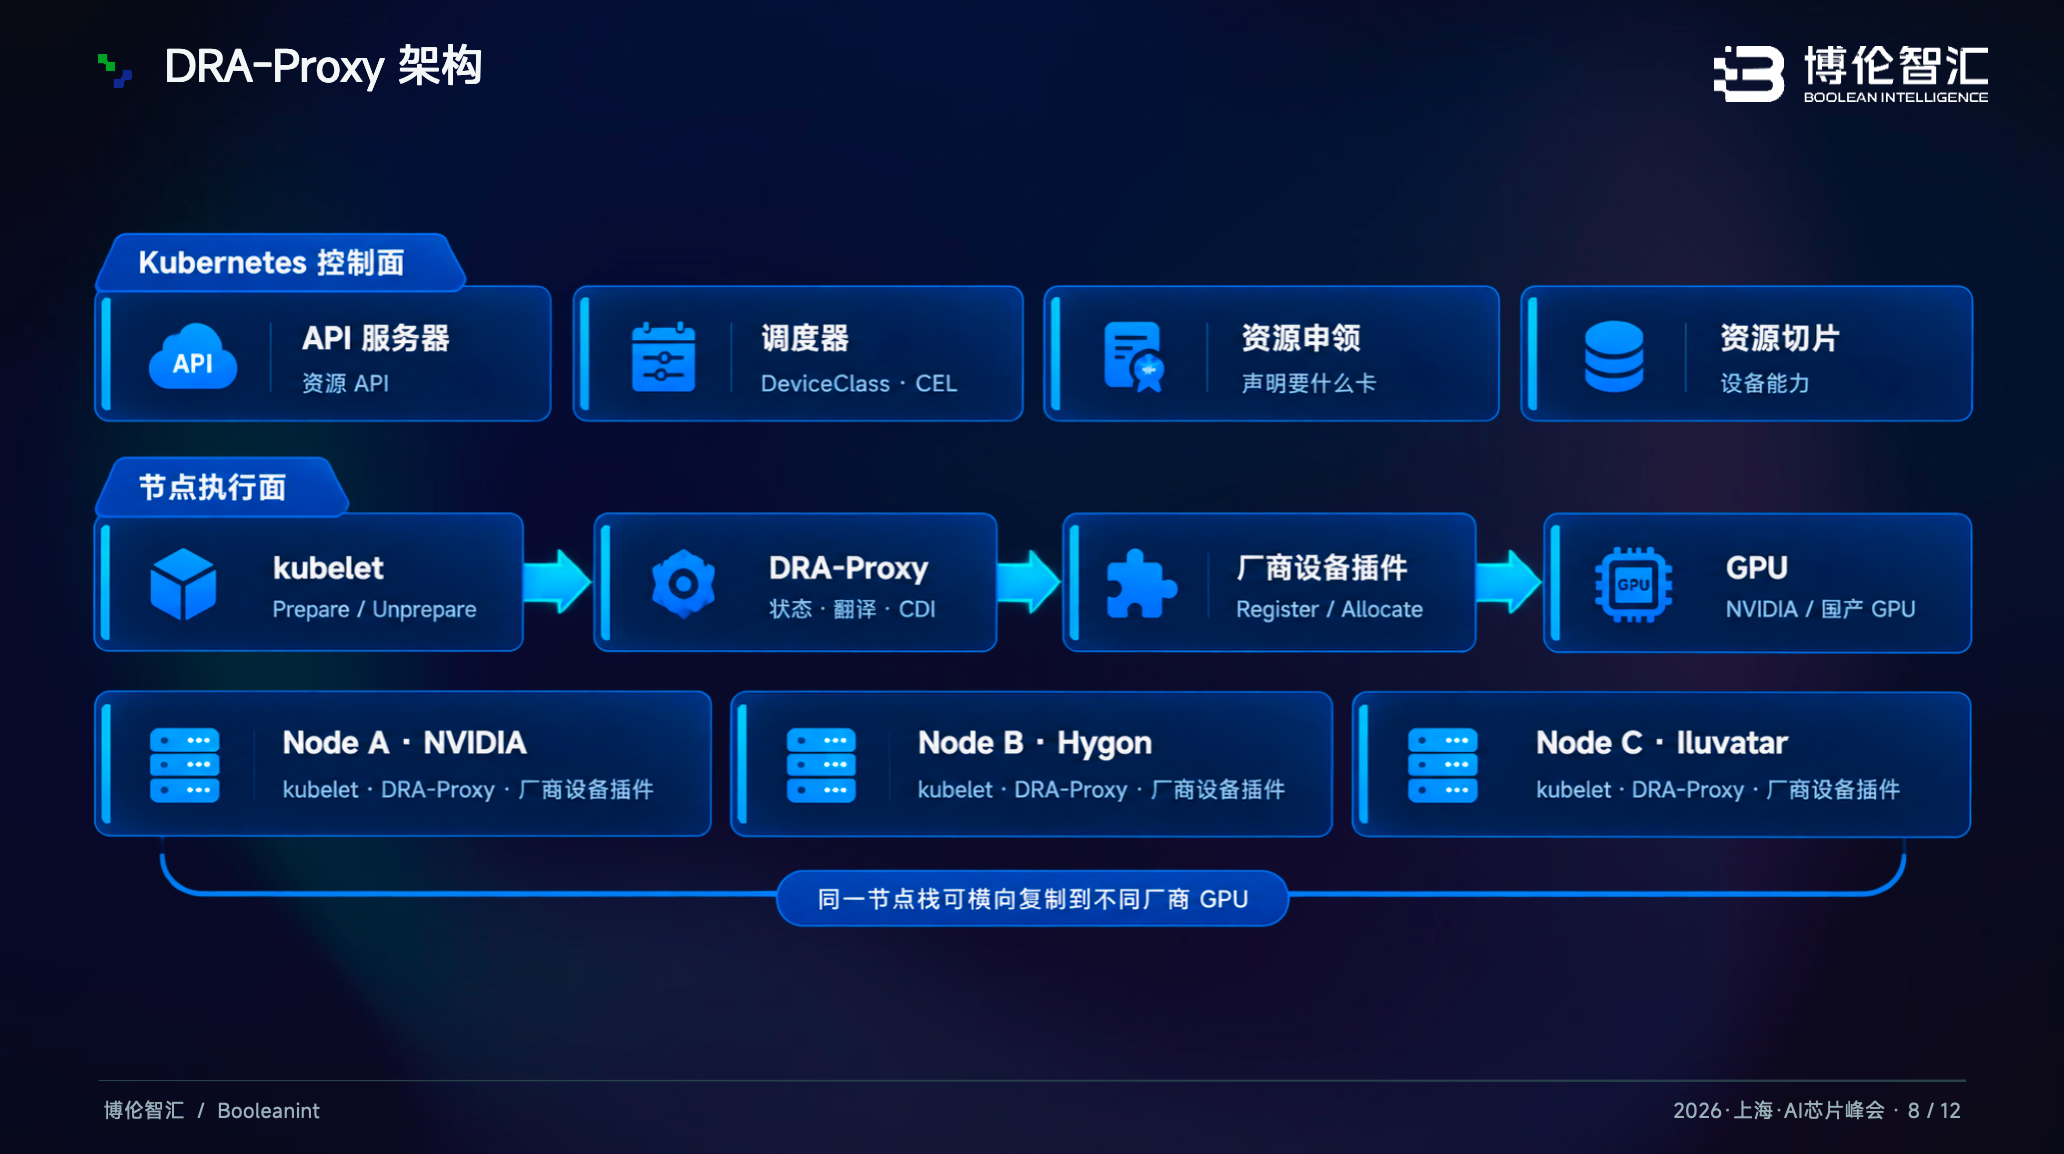
K8s控制面:API服务器接收资源切片入库(资源发现);调度器根据资源切片把任务调度到最优节点。
节点执行面:设备插件通过DRA Proxy的Unix Socket完成设备注入;调度请求到达节点后,K8s调用DRA Proxy准备资源,最终通过设备插件完成资源交付。
TOLD架构:面向Token的大模型分布式架构
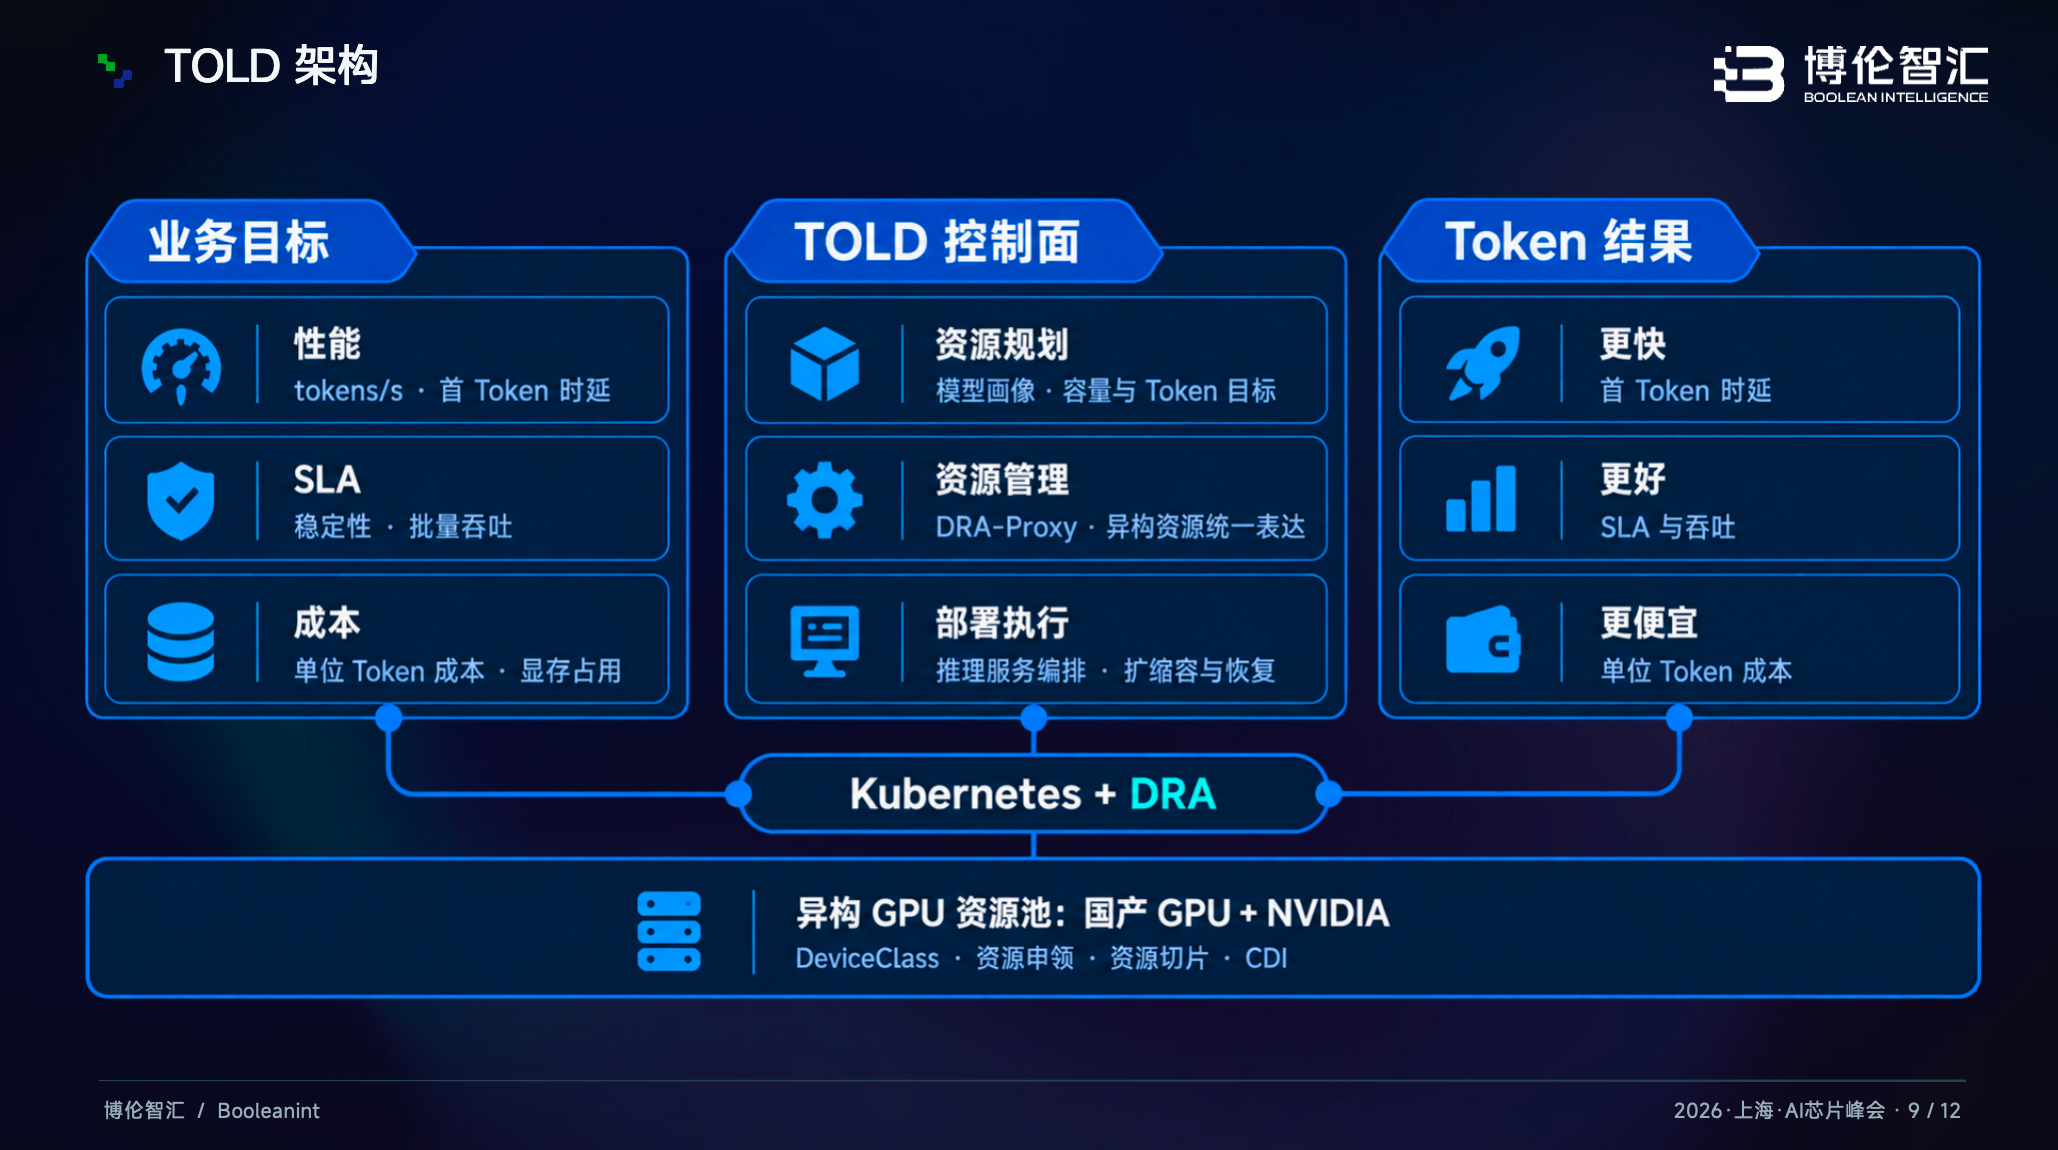
TOLD架构以低时延、高吞吐、低成本为目标。在控制面上,资源规划系统会在推理服务需求到来时,先对推理服务做需求拆分,确定具体需要的GPU型号、显存大小、GPU个数,把这个详细的清单下发给资源管理系统;资源管理系统完成真正的资源交付;最后把交付的资源给到推理服务部署系统,完成推理服务的编排和自动扩缩容。交付给用户的,就是更快、更好、更便宜的Token!
更低接入成本,更全能力释放
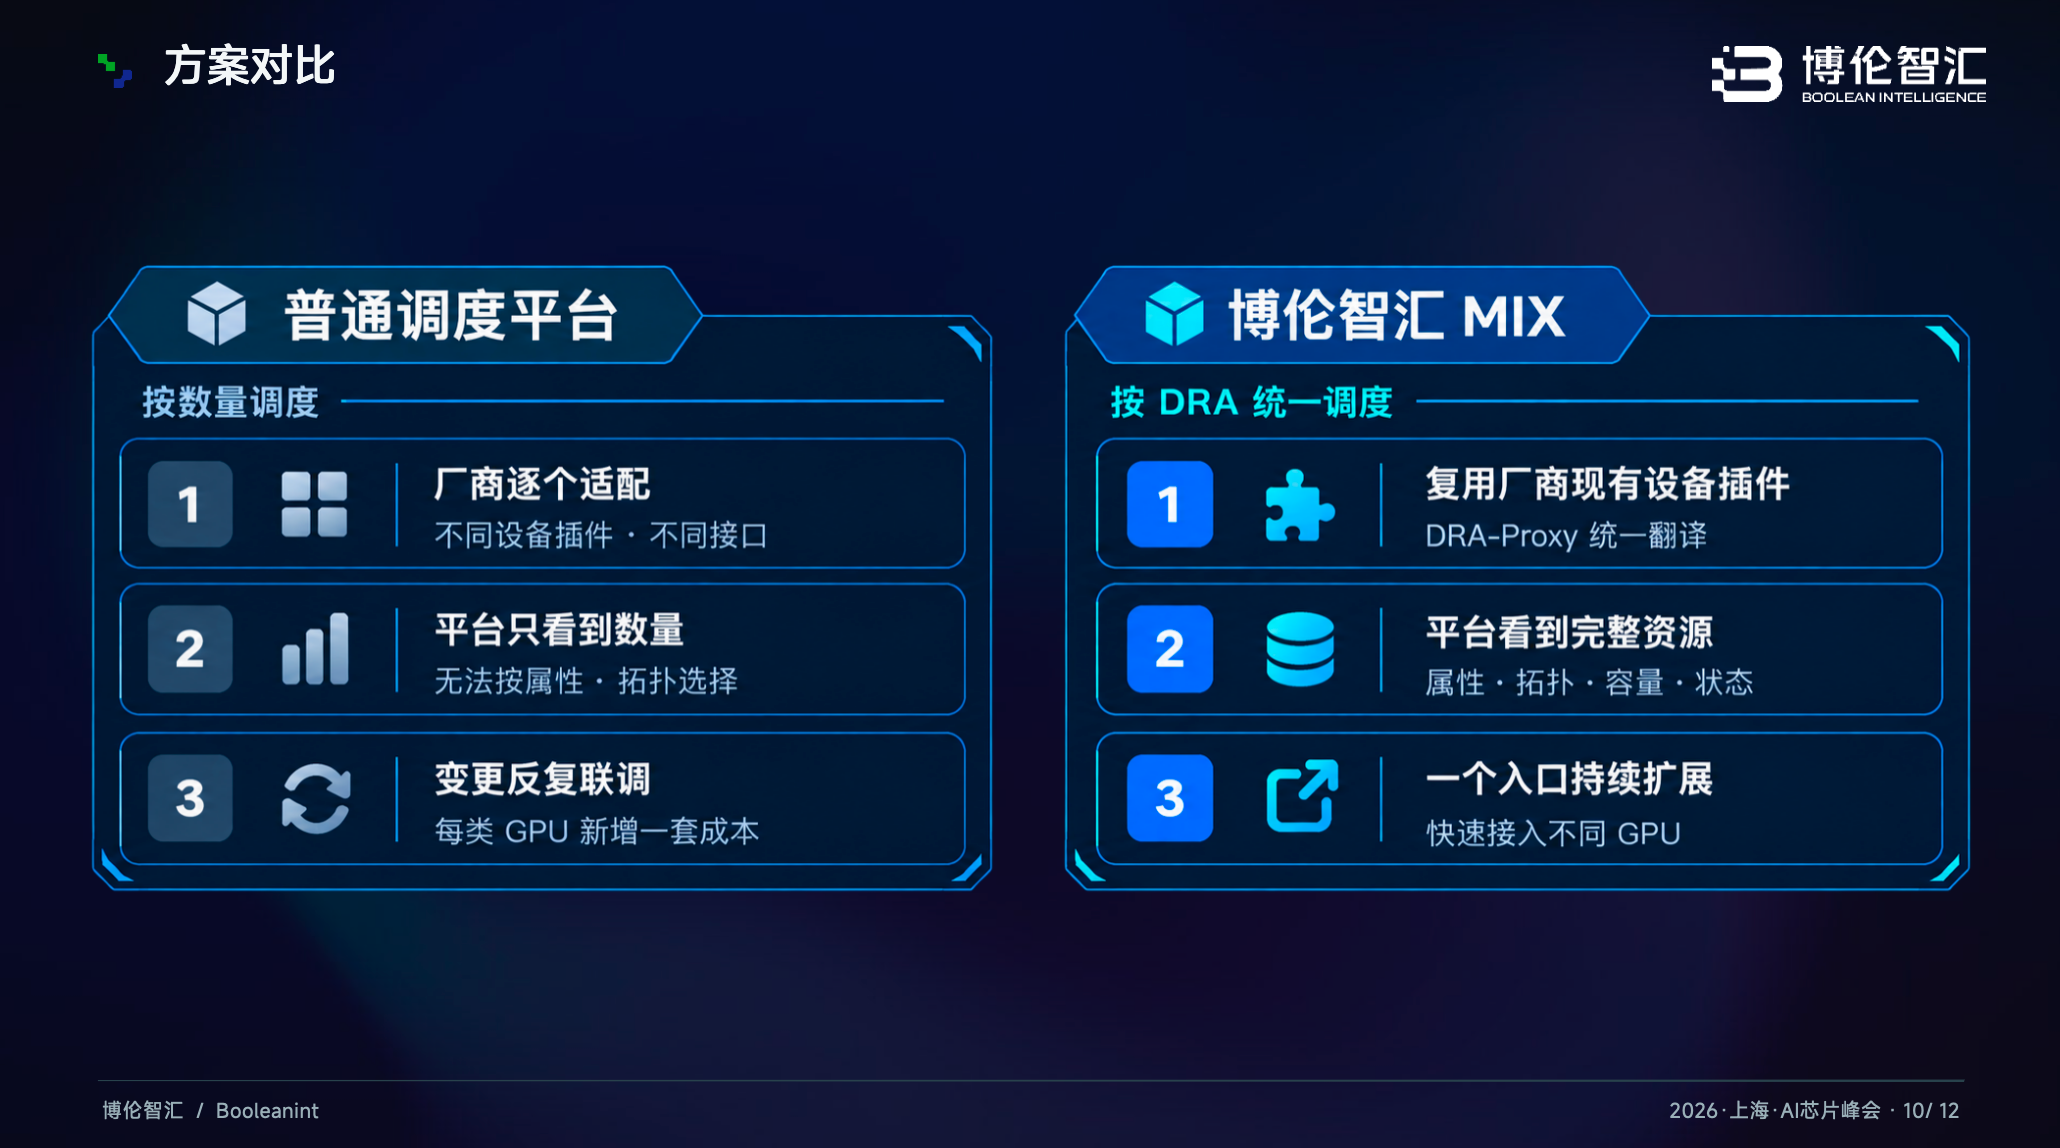
普通调度平台:新GPU需大量适配开发,成本高;GPU能力不能被平台完整识别,能力打折。博伦智汇Mix平台更低接入成本,更全能力释放: 1.直接复用厂家设备插件,芯片接入更快 2.补足DRA生态,平台完整识别设备能力
实测数据:多厂商GPU统一调度
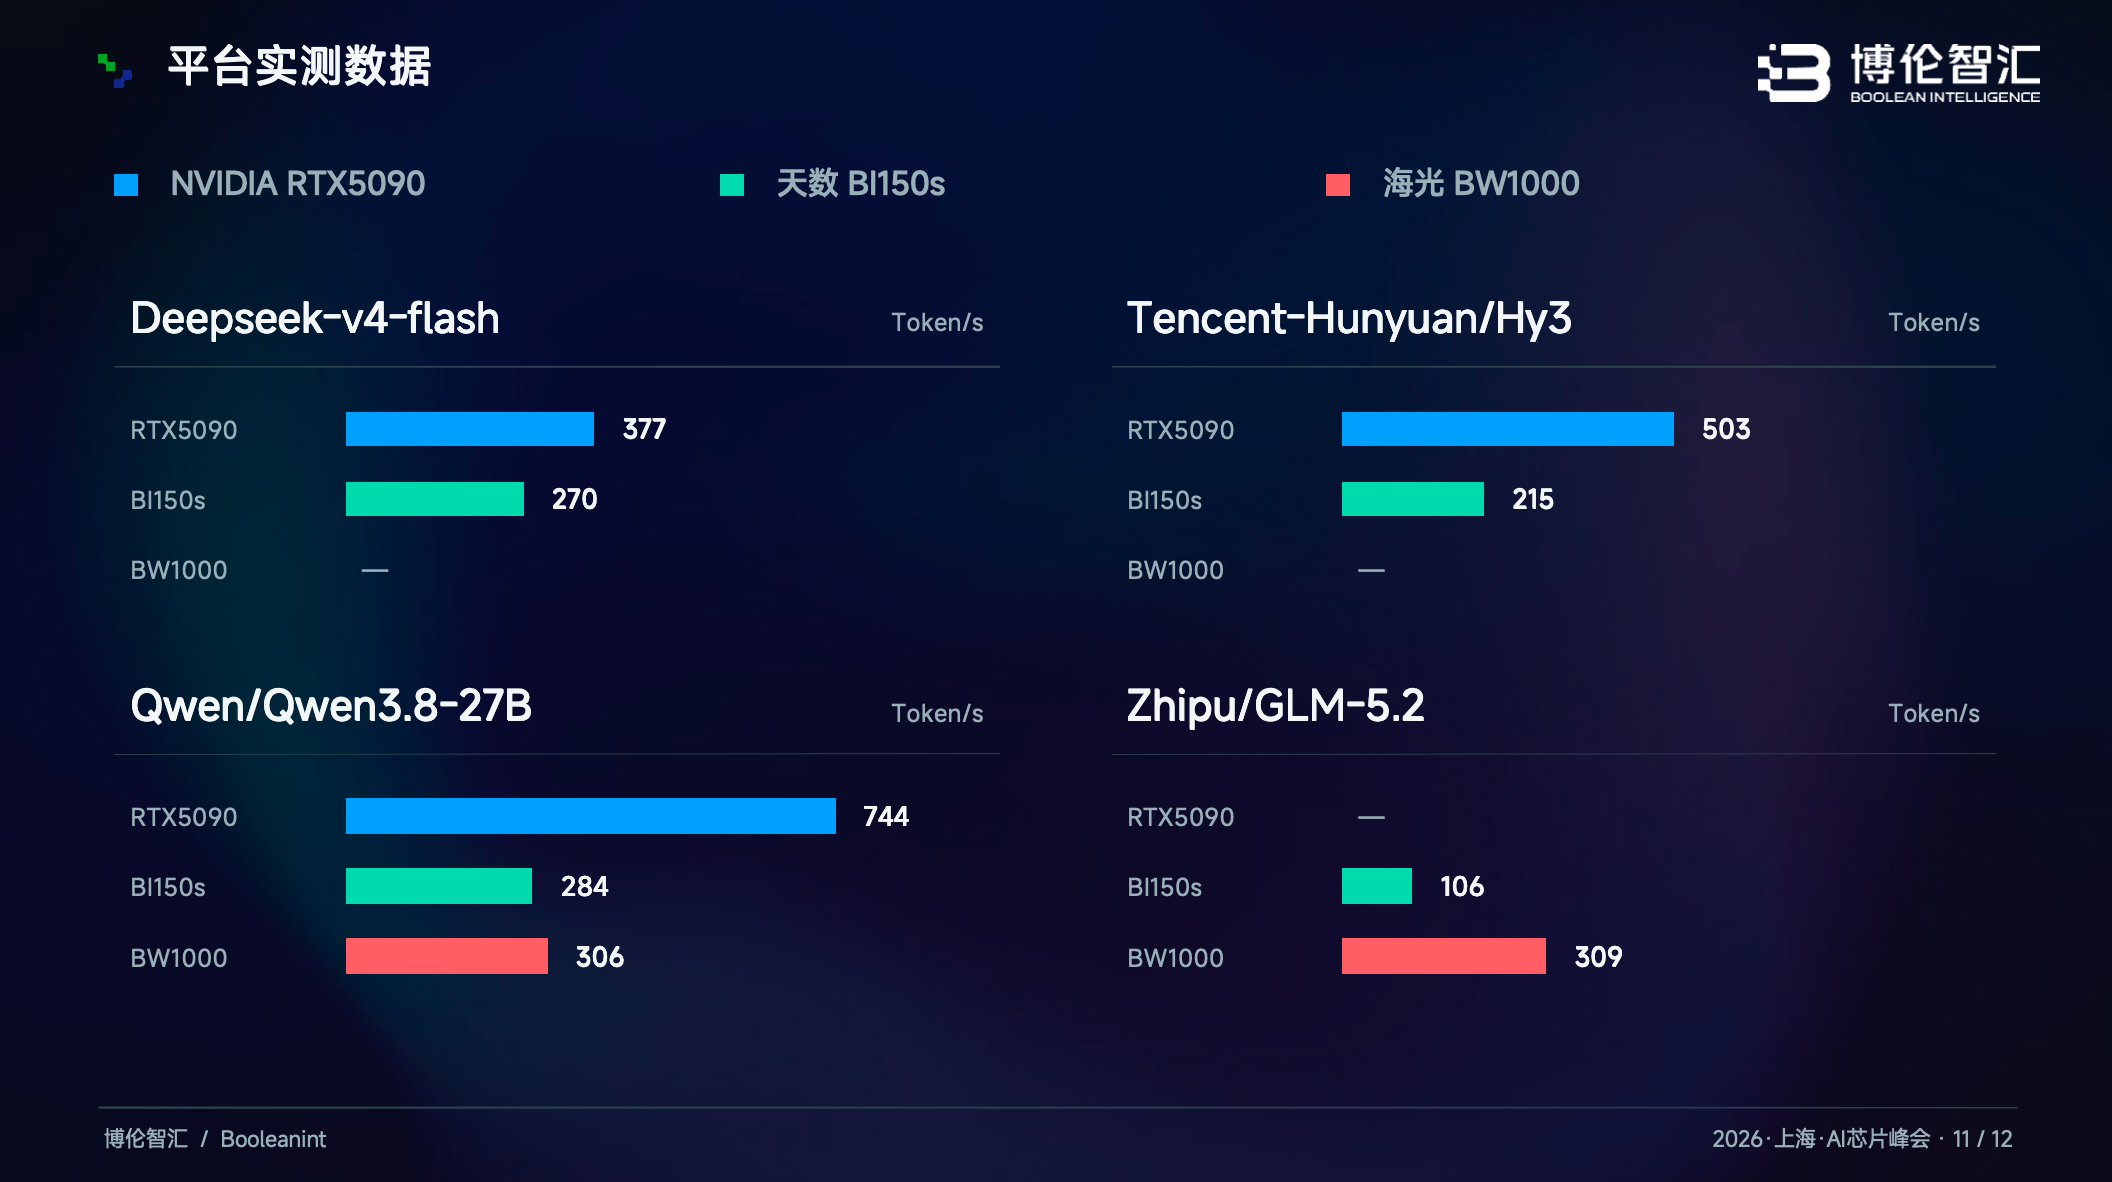
不仅NVIDIA生态完善,天数、海光等DRA生态不完整的厂家也能跑起来。DeepSeek-v4-flash、Hunyuan Hy3、Qwen3.8-27B、GLM-5.2等旗舰模型,均可在不同芯片上运行。大家尽管造更好的芯片,博伦智汇解决"最后一公里",让芯片跑起来。
国产算力的下一程,不只是把芯片造出来,更是让算力成为随取随用、按需而动的公共资源。
芯片不因生态而闲置,企业不因门槛而却步
博伦智汇愿为芯片厂商提供更简单快捷的接入方式,为平台用户提供更便捷的部署体验,让国产芯片从"用得了"走向"用得好",共同填补国内算力的空缺,让普惠算力惠及每一位创造者。