

大模型服务的落地,需要解决的不只是模型能否运行。不同算力环境如何管理,模型与推理引擎如何适配,部署过程如何验证,服务运行后如何监控和升级,都是平台需要持续解决的问题。
BooleanMix 是博伦智汇面向算力资源与模型服务管理打造的平台。通过管控中心与租户工作台,MIX 将资源组织、模型部署、服务管理和运行监控连接起来。围绕这条主线,平台经过四次上线,逐步扩展模型与硬件适配,完善部署运维,并向更连续、更规范的模型服务交付演进。
2026.7首次上线:建立从资源管理到模型服务交付的基础体系
BooleanMix 首次上线,建立了管控中心与租户工作台两类入口,分别承接公司侧的异构算力统一管理与租户侧的资源使用、服务运维需求。
管控中心提供账户、租户、算力资源分配和模型管理能力,支持模型添加、安装与发布;租户工作台提供模型服务、聚合模型服务、资源总览、基础监控和访问控制,让租户能够管理已有资源、组织模型服务,并掌握运行情况。
这一阶段形成了平台的基本技术链路:底层算力经过组织与分配,用于部署模型;模型部署后形成可调用的服务,再通过聚合模型服务组织访问入口。模型资产、运行服务与聚合入口分工明确,为后续的模型扩展、服务维护和应用接入建立了基础。
资源总览与基础监控则让平台管理从“完成部署”延伸到“持续掌握运行情况”。资源配置、服务状态与访问控制共同构成日常运维的基础,使算力和模型能够在统一的平台流程中得到管理。
2026.9.11第二次上线: 扩展模型与国产算力适配,深入完善部署运维
第二次上线重点围绕模型支持、推理框架、部署验证与运维能力展开。
在模型服务方面,平台增加模型支持,建设基于 Diffusers 的模型服务框架,补充图像、视频生成相关推理能力,并推进天数系列、海光 BR 系列芯片相关推理引擎适配。这些工作进一步扩展了平台服务不同模型任务和算力环境的能力,也体现了博伦智汇在模型、推理软件栈与国产硬件之间开展适配的技术积累。
面对不同模型和运行环境的配置差异,MIX 增加模型服务自定义启动参数,并在 Manifest 配置描述中补充相关信息。部署参数由此能够随模型服务的实际需要进行调整,为不同部署场景提供更灵活的配置方式。
模型安装流程也进一步引入验证环节。平台将测试工具接入安装步骤,把测试结果写入 Manifest,同时验证并记录特定模型与 GPU 组合启动推理服务所需的时间。这使部署准备不仅包含模型文件和启动配置,还积累了与实际运行环境相关的验证信息,为后续部署检查和问题排查提供依据。
在运维侧,平台补充模型安装错误日志与推理服务 Pod 日志,对接文生视频监控,并增加视频文件安全保护下载。同时,恢复无推理服务运行时的模型卸载功能,完善模型生命周期管理。
从适配、配置、验证到日志和监控,这一版本将技术工作贯穿于模型服务运行前后的多个环节,使平台的能力从基础管理进一步延伸到部署质量与运行维护。
2026.9.20第三次上线:增加品牌展示配置,完善租户交付体验
第三次上线响应B端用户实时需求,聚焦租户品牌展示需求。
平台支持通过租户工作台修改 Client 级别的背景、文案与公司 Logo,让B端用户能够在已有服务基础上配置面向用户的品牌展示。
这一更新将指定展示元素纳入后台配置范围,为不同租户提供更直接的品牌调整方式。对于使用 MIX 组织模型服务的企业而言,平台不仅提供资源与部署管理,也开始进一步完善服务交付后的展示体验。
这一阶段的变化虽然集中,但补充了平台产品化交付中的一个具体环节:让底层模型服务与面向B端用户的品牌表达能够更好地衔接。
2026.10第四次上线:优化服务连续性,完善模型持续交付能力
随着模型不断更新,平台需要在持续迭代与现有服务运行之间取得平衡。第四次上线重点转向推理服务升级、镜像分发和新模型交付流程。
Inference Service 增加无缝升级能力,支持模型优化后的不停服更新,并支持清理无用资源,减少升级对业务的影响。平台对模型服务的管理进一步覆盖持续更新过程,让模型优化能够更平稳地进入服务环境。
在推理引擎分发方面,平台规范推理框架镜像的项目归属,并优化中心至边缘镜像仓库的同步机制,按需分发推理引擎镜像。这有助于减少不必要的镜像传输和存储占用,使分发过程更加贴合实际部署需求。
兼容性也是这一版本的重要内容。新版服务管理组件 max-operator-ng 兼容旧版服务,现有服务无需强制升级,可逐步切换。通过兼容旧版与渐进迁移,平台为底层组件更新保留了更灵活的实施空间。
与此同时,新模型上线流程进一步规范。完成适配的新模型可按既定流程上线,便于持续提供新的模型服务。模型适配、镜像准备、服务更新与版本兼容由此得到更紧密的组织,推动平台形成更规范的持续交付过程。
本轮还包含技术能力配套建设:大模型 Benchmark 测试平台初步搭建,模型压力测试工具与 Jenkins 集成、面向 ARM 节点的多架构 CI/CD 改造纳入研发工作;Edge 集群与 Box/Mix 的集成策略,以及 LLM-D、GIE 则开展调研与方案研究。这些工作为后续技术演进积累验证工具和方案依据,其中研究验证内容已与线上产品形成迭代呼应,明确后续版本技术能力深化方向。
BooleanMix演进背后的架构主线:TOLD技术栈
四次产品发布呈现的是团队面向需求的快速迭代能力;而这条路径带给我们的,即是博伦智汇自主知识产权的 TOLD 解决方案(Token-Oriented Large-scale Distributed Architecture),即在人工智能时代,“面向 Token 的大规模分布式架构”。
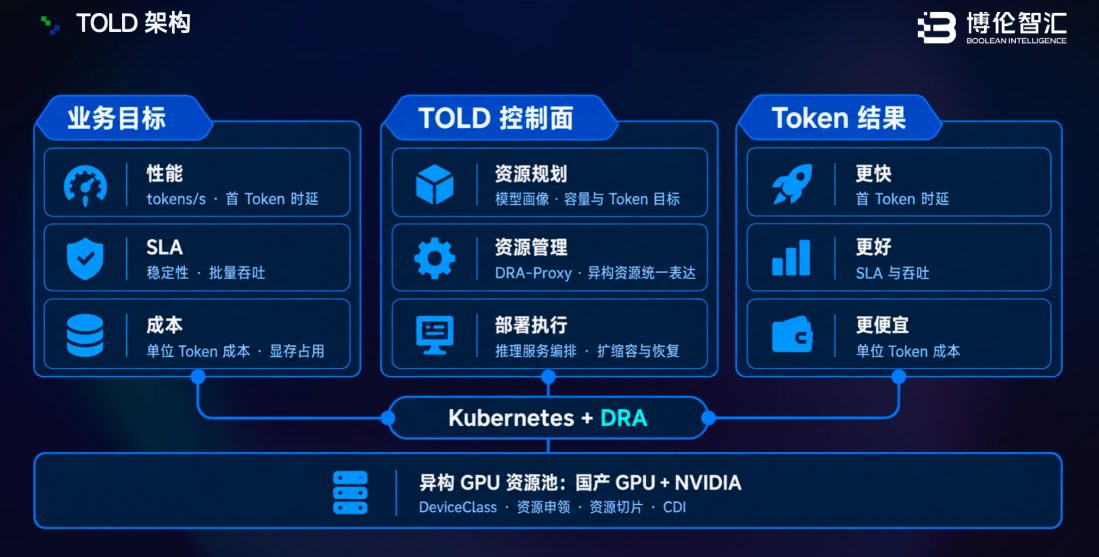
传统算力调度是“资源导向”:先看有什么 GPU,再适配部署;TOLD 将顺序反转——先理解用户需要什么样的 Token,再反向推导算力、模型与调度策略,让算力从“有什么用什么”变成“要什么给什么”。
打个比方:资源导向的调度像一家只有卡车的物流公司,无论急件还是小件,一律用卡车配送;TOLD 更像智能物流调度中心——先弄清这批“货”的属性与时效,再决定用什么“车”、走什么“路”,必要时拆分订单、协同配送。Token,就是被调度的“货”。
TOLD的控制面是博伦智汇针对Kubernetes和云原生的能力进行扩展开发,使之更适合于异构异地场景下按Token需求调度的场景。简言之,我们主要通过以下在Kubernetes上的扩展,把TOLD落地于BooleanMix平台,从而构建可观测,易使用,高效率,多租户的用户场景。这些扩展具体通过五个 Operator 实现:DRA-Proxy 让国产芯片以 DRA 方式被 Kubernetes 调度;Model-Operator 管理模型全生命周期;Image-Warmup-Operator 预热镜像、加快服务启动;Inference-Operator 负责推理服务扩缩容与故障恢复;Tenant-Operator 保障多租户隔离。
围绕实际交付需求,持续积累平台技术能力
BooleanMix 清晰的技术发展路径:首先建立资源与服务管理体系,再扩展模型和硬件适配、深入部署验证与运行维护,随后完善租户展示配置,并进一步优化服务升级与持续交付。
博伦智汇的平台技术能力,也体现在这些相互衔接的工程环节中:适配不同模型与异构算力环境,将验证信息纳入部署流程,通过日志和监控支持运行维护,再以兼容机制和规范流程支撑持续更新。
围绕模型服务的实际运行与交付需求,BooleanMix 正逐步完善从算力资源到可用模型服务的技术支撑,让企业能够更有序地部署、管理和持续迭代 AI 服务。